Bajo pedido
Para entrenar modelos de IA y LLM
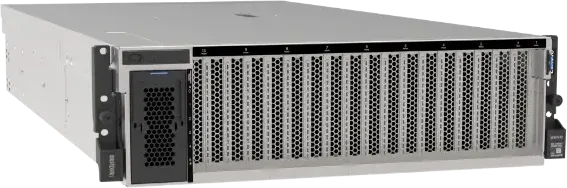
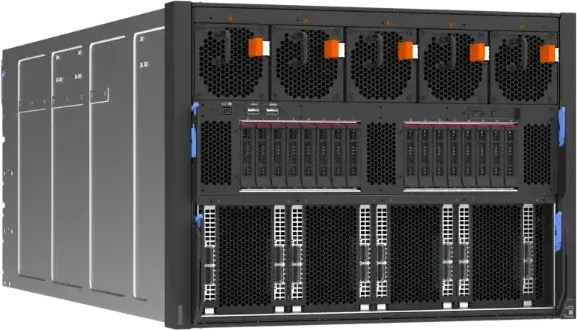
ThinkSystem SR680a V3
- Rack 8U · 2 Intel Xeon de 5.ª generación
- 8 GPU NVIDIA HGX H100, H200 o B200
- NVLink de hasta 1,8 TB/s entre GPU
- Hasta 4 TB de memoria DDR5
- Hasta 16 SSD NVMe hot-swap
Servidores Lenovo para entrenar, ejecutar y escalar tus modelos de IA.
Bajo pedido
Para entrenar modelos de IA y LLM
Para entrenamiento, inferencia y HPC con GPU
Bajo pedido
Para supercómputo e IA a gran escala
Para inferencia, virtualización y bases de datos
Para IA, virtualización y almacenamiento definido por software
Para VDI, análisis e inferencia con un solo procesador
Para centros de datos con poco espacio en rack
Para virtualización y análisis de datos en 1U
Para IA en el borde: tiendas, plantas y telco
Para SAP HANA, bases de datos y virtualización
Para cargas críticas con GPU y mucha memoria
Depende de lo que vas a hacer. Para entrenar modelos o LLM necesitas varias GPU interconectadas, como en el SR680a V3 o el SR675 V3. Para ejecutar modelos ya entrenados (inferencia) suele bastar un servidor de 2U con GPU, como el SR650 V3 o el SR665 V3. Si tu prioridad es la memoria, como en SAP HANA, mira el SR850 V3 o el SR860 V3.
Entrenar es enseñarle al modelo con grandes volúmenes de datos: exige muchas GPU trabajando juntas durante horas o días. La inferencia es usar el modelo ya entrenado para responder; necesita menos GPU, pero respuesta rápida y estable.
Cada servidor se arma a la medida: procesador, memoria, GPU, discos, red y garantía cambian el precio. Cuéntanos tu caso por WhatsApp y te enviamos la cotización de la configuración que necesitas.
Tienen garantía oficial de Lenovo de 1 o 3 años según la referencia (machine type), con servicio en sitio al siguiente día hábil opcional. La ficha de cada modelo indica sus referencias.
Son modelos que Lenovo ya reemplazó por una generación nueva. Confirmamos la disponibilidad y el tiempo de entrega al cotizar, o te proponemos el modelo equivalente actual.
Sí. Coordinamos la entrega en Bogotá, Medellín, Cali, Barranquilla y el resto del país por WhatsApp.